Связаться с нами
В современных реалиях финансового планирования ручной мониторинг обменных пунктов неэффективен. Для бизнеса, завязанного на импортно-экспортных операциях, важна не секундная волатильность, а среднесрочные тренды.
В этой статье мы подробно разберем создание автономного production-ready комплекса на Python.
Парсинг исторических финансовых данных требует деликатного подхода к управлению сетевыми запросами и структурированию сырого HTML. Вместо использования тяжеловесных фреймворков автоматизации браузера (вроде Selenium), наш модуль MigParser спроектирован на базе легковесной связки requests и BeautifulSoup. Это минимизирует накладные расходы на оперативную память и процессорное время.
Для оптимизации сетевого взаимодействия внутри класса MigParser создается персистентная сессия requests.Session(). Это позволяет использовать механизм HTTP Keep-Alive, повторно отправляя запросы через одно и то же TCP-соединение, что ускоряет сбор данных.
Для обхода базовых фильтров по типу «антибот» в заголовки сессии принудительно внедряется валидный User-Agent:
class MigParser:
    """Класс для парсинга и предобработки архивных курсов валют с сайта mig.kz."""
    BASE_URL = 'https://mig.kz'

    def __init__(self):
        self.session = requests.Session()
        self.session.headers.update({
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) '
                          'AppleWebKit/537.36 (KHTML, like Gecko) '
                          'Chrome/120.0.0.0 Safari/537.36'
})Сайт mig.kz использует специфический механизм выдачи архивных данных через отправку форм. При запросе информации за широкий временной интервал сервер генерирует пагинацию. Чтобы собрать все данные, парсер сначала выполняет «пристрелочный» POST-запрос с указанием периода, вычисляет общее количество страниц через анализ элемента .pagination, а затем последовательно сканирует оставшиеся страницы.
def _request_page(self, url: str, page_number: int, payload: dict) -> str:
    """Выполняет POST-запрос к архиву и возвращает HTML-текст страницы."""
    payload['page'] = str(page_number)
    try:
        response = self.session.post(url, data=payload, timeout=15)
        response.raise_for_status()
        return response.text
    except requests.RequestException as e:
        logger.error(f"Сетевая ошибка при запросе страницы {page_number}: {e}")
        return ""

def _get_pages_count(self, html: str) -> int:
    if not html:
        return 0
    soup = self._get_soup(html)
    pagination = soup.find('ul', class_='pagination')
return len(pagination.find_all('li')) if pagination else 1Извлечение данных со страницы инкапсулировано в методе get_table_data. Главная инженерная задача здесь — динамически сформировать имена колонок датафрейма на основе классов HTML-ячеек (td, th), так как они содержат маркеры валют (например, usd-buy, usd-sell).
def get_table_data(self, html: str) -> pd.DataFrame | None:
    if not html:
        logger.warning("Данных для парсинга не найдено!")
        return None

    soup = self._get_soup(html)
    table = soup.find('tbody')
    if table is None:
        logger.warning("Таблица пустая - нет строк!")
        return None

    cell_name = []
    out_table = []
    for row in table.find_all('tr'):
        cells = row.find_all(['td', 'th'])
        if not cells:
            continue

        if not cell_name:
            # Извлекаем техническое имя колонки из названия css-класса
            cell_name = [cell.get("class")[0] if cell.get("class") else f"col_{i}"
                         for i, cell in enumerate(cells)]

        row_data = [cell.get_text(strip=True) for cell in cells]
        if row_data:
            out_table.append(row_data)

    if not out_table:
        logger.warning("Не удалось собрать строки из таблицы!")
        return None

return pd.DataFrame(out_table, columns=cell_name)Сырые данные с сайта приходят со строковыми датами на русском языке (например, 15 января 2026 12:00). Для математических моделей такой формат непригоден. Метод _change_data_to_df выполняет строковый маппинг с помощью регулярных выражений, заменяя названия месяцев на их цифровые эквиваленты, убирает паразитные пробелы и формирует чистую колонку date:
def _change_data_to_df(self, df: pd.DataFrame, delite_data_coll=True) -> pd.DataFrame:
    months_map = {
        r'\bянваря\b': '.01.', r'\bфевраля\b': '.02.', r'\bмарта\b': '.03.',
        r'\bапреля\b': '.04.', r'\bмая\b': '.05.', r'\bиюня\b': '.06.',
        r'\bиюля\b': '.07.', r'\bавгуста\b': '.08.', r'\bсентября\b': '.09.',
        r'\bоктября\b': '.10.', r'\bноября\b': '.11.', r'\bдекабря\b': '.12.'
    }
    clean_date = df['date-label'].str.lower().replace(months_map, regex=True)
    clean_date = clean_date.str.replace(r'\s+\.\s*', '.', regex=True).str.replace(r'\s*\.\s+', '.', regex=True)

    df.insert(0, 'date', clean_date)
    if delite_data_coll:
        df.drop('date-label', axis=1, inplace=True)
return dfДля долгосрочного накопления истории не обязательно разворачивать громоздкие СУБД. Плоский файл CSV, структурированный через библиотеку pandas, полностью закрывает эту потребность, если соблюдены правила дедупликации и атомарности записи.
При циклическом парсинге новые порции данных неизбежно пересекаются со старыми. Функция process_and_append_data предотвращает раздувание базы: она считывает существующий файл, приводит даты к типу datetime64[ns], производит конкатенацию с новыми данными, а затем удаляет дубликаты методом drop_duplicates(subset=[date_col], keep='first').
Запись данных напрямую в рабочий файл result.csv чревата его полной порчей, если в процессе записи произойдет сбой питания или аварийная остановка скрипта.
Для защиты данных применена концепция атомарной замены:
Данные сохраняются во временный файл во избежание блокировок или повреждений (result.csv.tmp).
С помощью системного вызова os.replace() операционная система мгновенно подменяет старый файл на новый. На уровне ОС эта операция выполняется одной атомарной транзакцией файловой системы.
def process_and_append_data(df: pd.DataFrame, file_name: str, sep: str, currencies: list, date_col: str = "date") -> None:
    if df is None or df.empty:
        logger.warning("На вход передан пустой датафрейм. Сохранение отменено.")
        return

    keep_cols = [date_col]
    if currencies:
        for curr in currencies:
            keep_cols.extend([f"{curr}-buy", f"{curr}-sell"])

    available_cols = [col for col in keep_cols if col in df.columns]
    df_new = df[available_cols].copy()

    try:
        df_new[date_col] = pd.to_datetime(df_new[date_col], format="%d.%m.%Y %H:%M", errors='coerce')
        df_new = df_new.dropna(subset=[date_col])
    except Exception as e:
        logger.error(f"Ошибка преобразования дат в новых данных: {e}")
        return

    if os.path.isfile(file_name):
        try:
            df_existing = pd.read_csv(file_name, sep=sep)
            df_existing[date_col] = pd.to_datetime(df_existing[date_col], format="%d.%m.%Y %H:%M", errors='coerce')
            df_existing = df_existing.dropna(subset=[date_col])

            old_count = len(df_existing)
            df_combined = pd.concat([df_existing, df_new], ignore_index=True)
            df_combined.drop_duplicates(subset=[date_col], keep='first', inplace=True)

            if len(df_combined) - old_count <= 0:
                logger.info("Новых уникальных записей нет. Файл истории не изменялся.")
                return
            df_final = df_combined
        except Exception as e:
            logger.error(f"Ошибка дедупликации файла: {e}. Запись прервана.")
            return
    else:
        df_final = df_new

    df_final.sort_values(by=date_col, ascending=True, inplace=True)

    # --- АТОМАРНАЯ ЗАПИСЬ ---
    temp_file = f"{file_name}.tmp"
    try:
        df_to_save = df_final.copy()
        df_to_save[date_col] = df_to_save[date_col].dt.strftime('%d.%m.%Y %H:%M')
        df_to_save.to_csv(temp_file, sep=sep, index=False, encoding="utf-8-sig")

        if os.path.exists(temp_file):
            os.replace(temp_file, file_name) # Мгновенная подмена на уровне ОС
        logger.info(f"Файл '{file_name}' успешно сохранен. Строк: {len(df_to_save)}.")
    except Exception as e:
        logger.critical(f"Критическая ошибка записи в CSV: {e}")
        if os.path.exists(temp_file):
os.remove(temp_file)Служба автоматизации организует бесконечный цикл сбора котировок с заданным интервалом, считывая параметры из файла конфигурации settings.toml через современный встроенный модуль tomllib (или внешний бэкпорт tomli для старых версий Python).
Для отправки уведомлений в Telegram-канал или чат обычно используют тяжелые асинхронные фреймворки вроде aiogram. Поскольку наша задача является линейно-последовательной (скрипт засыпает на несколько часов), мы реализовали клиент на базе стандартного модуля urllib.request. Это исключает лишние зависимости и гарантирует высокую скорость исполнения.
def send_telegram_message(text: str = '', TG_TOKEN: str = None, TG_CHAT_ID: str = None) -> None:
    if not TG_TOKEN or not TG_CHAT_ID:
        return

    text = text[:4000] # Ограничение Telegram API на длину сообщения
    token = str(TG_TOKEN).strip()
    url = f"https://telegram.org{token}/sendMessage"
    payload = {"chat_id": str(TG_CHAT_ID).strip(), "text": text, "parse_mode": "HTML"}

    try:
        data = json.dumps(payload).encode('utf-8')
        req = urllib.request.Request(
            url, data=data,
            headers={'Content-Type': 'application/json'},
            method='POST'
        )
        with urllib.request.urlopen(req, timeout=5) as response:
            if response.status == 200:
                logging.info("Уведомление в Telegram успешно отправлено!")
    except Exception as e:
logging.error(f"Не удалось отправить уведомление в Telegram: {e}")Мониторинг лимитов проверяет исключительно свежий чанк полученных данных (df_tmp), не нагружая процессор проверкой всей исторической базы. Из последней строки извлекается текущий курс покупки валюты и сравнивается с пороговыми значениями min и max из файла конфигурации:
# Фрагмент логики из run_parser_service()
current_value = float(df_tmp[column_name_buy].iloc[-1])
limit_min = float(limits_config.get(currency)['min'])
limit_max = float(limits_config.get(currency)['max'])

if current_value < limit_min or current_value > limit_max:
    if current_value < limit_min:
        emoji = f"🟢 - цена покупки {currency.upper()} опустилась ниже заданного предела"
    else:
        emoji = f"🔴 - цена покупки {currency.upper()} поднялась выше заданного предела"

    msg_text = (
        f"{emoji}\n"
        f"📊 <b>Текущая цена: {current_value}</b>\n\n"
        f"💰 Заданный порог: <code>{limit_min} - {limit_max}</code>\n"
    )
send_telegram_message(text=msg_text, TG_TOKEN=TG_TOKEN, TG_CHAT_ID=TG_CHAT_ID)Сбор данных — это лишь фундамент. Перейдем к самому ценному этапу — математическому прогнозированию тренда.
Сырой лог содержит хаотичные внутридневные котировки (курсы меняются несколько раз в день в случайные минуты). Для построения качественной прогнозной модели данные необходимо агрегировать к стабильному дневному интервалу.
Функция load_and_prepare_data выполняет операцию ресемплинга .resample('D').mean(). Она вычисляет среднее арифметическое значение курса за каждые сутки. Возникающие пробелы (например, в выходные или праздничные дни, когда обменные пункты не обновляли информацию) сглаживаются методами прямого и обратного заполнения (ffill().bfill()). Это гарантирует непрерывность временного интервала — обязательное условие для моделей класса ARIMA.
def load_and_prepare_data(file_name: str, sep: str, currency: str, price_type: str) -> pd.Series:
    if not os.path.exists(file_name):
        logger.critical(f"Файл данных '{file_name}' не найден!")
        sys.exit(1)

    column_name = f"{currency}-{price_type}"
    df = pd.read_csv(file_name, sep=sep, usecols=["date", column_name])
    df["date"] = pd.to_datetime(df["date"], format="%d.%m.%Y %H:%M")
    df = df.set_index("date").sort_index()

    # Сглаживание внутридневных колебаний и заполнение пропусков
    daily_series = df[column_name].resample('D').mean()
    daily_series = daily_series.ffill().bfill()

    if len(daily_series.dropna()) < 10:
        logger.critical("Недостаточно данных для обучения модели!")
        sys.exit(1)

return daily_seriesДля анализа мы используем модель SARIMAX (Seasonal Autoregressive Integrated Moving Average со сторонними регрессорами) из пакета statsmodels. Наш базовый порядок модели сконфигурирован как order=(1, 1, 1). Разберем, за что отвечает каждый параметр:
p = 1 (Autoregressive component - AR): Показывает зависимость текущего значения от предыдущих периодов. Модель учитывает курс за вчерашний день, закладывая в прогноз инерцию финансового рынка.
d = 1 (Integrated component - I): Отвечает за интегрирование (взятие разностей временного ряда). Большинство валютных котировок нестационарны — у них есть глобальный повышательный или понижательный тренд. Параметр d=1 переводит модель с абсолютных значений курса на анализ изменений (разностей между днями), что делает ряд стационарным и пригодным для анализа.
q = 1 (Moving Average component - MA): Компонент скользящего среднего. Он анализирует прошлые ошибки прогноза, позволяя алгоритму быстро гасить случайный шум и краткосрочные рыночные шоки, не ломая общую структуру прогнозирования.
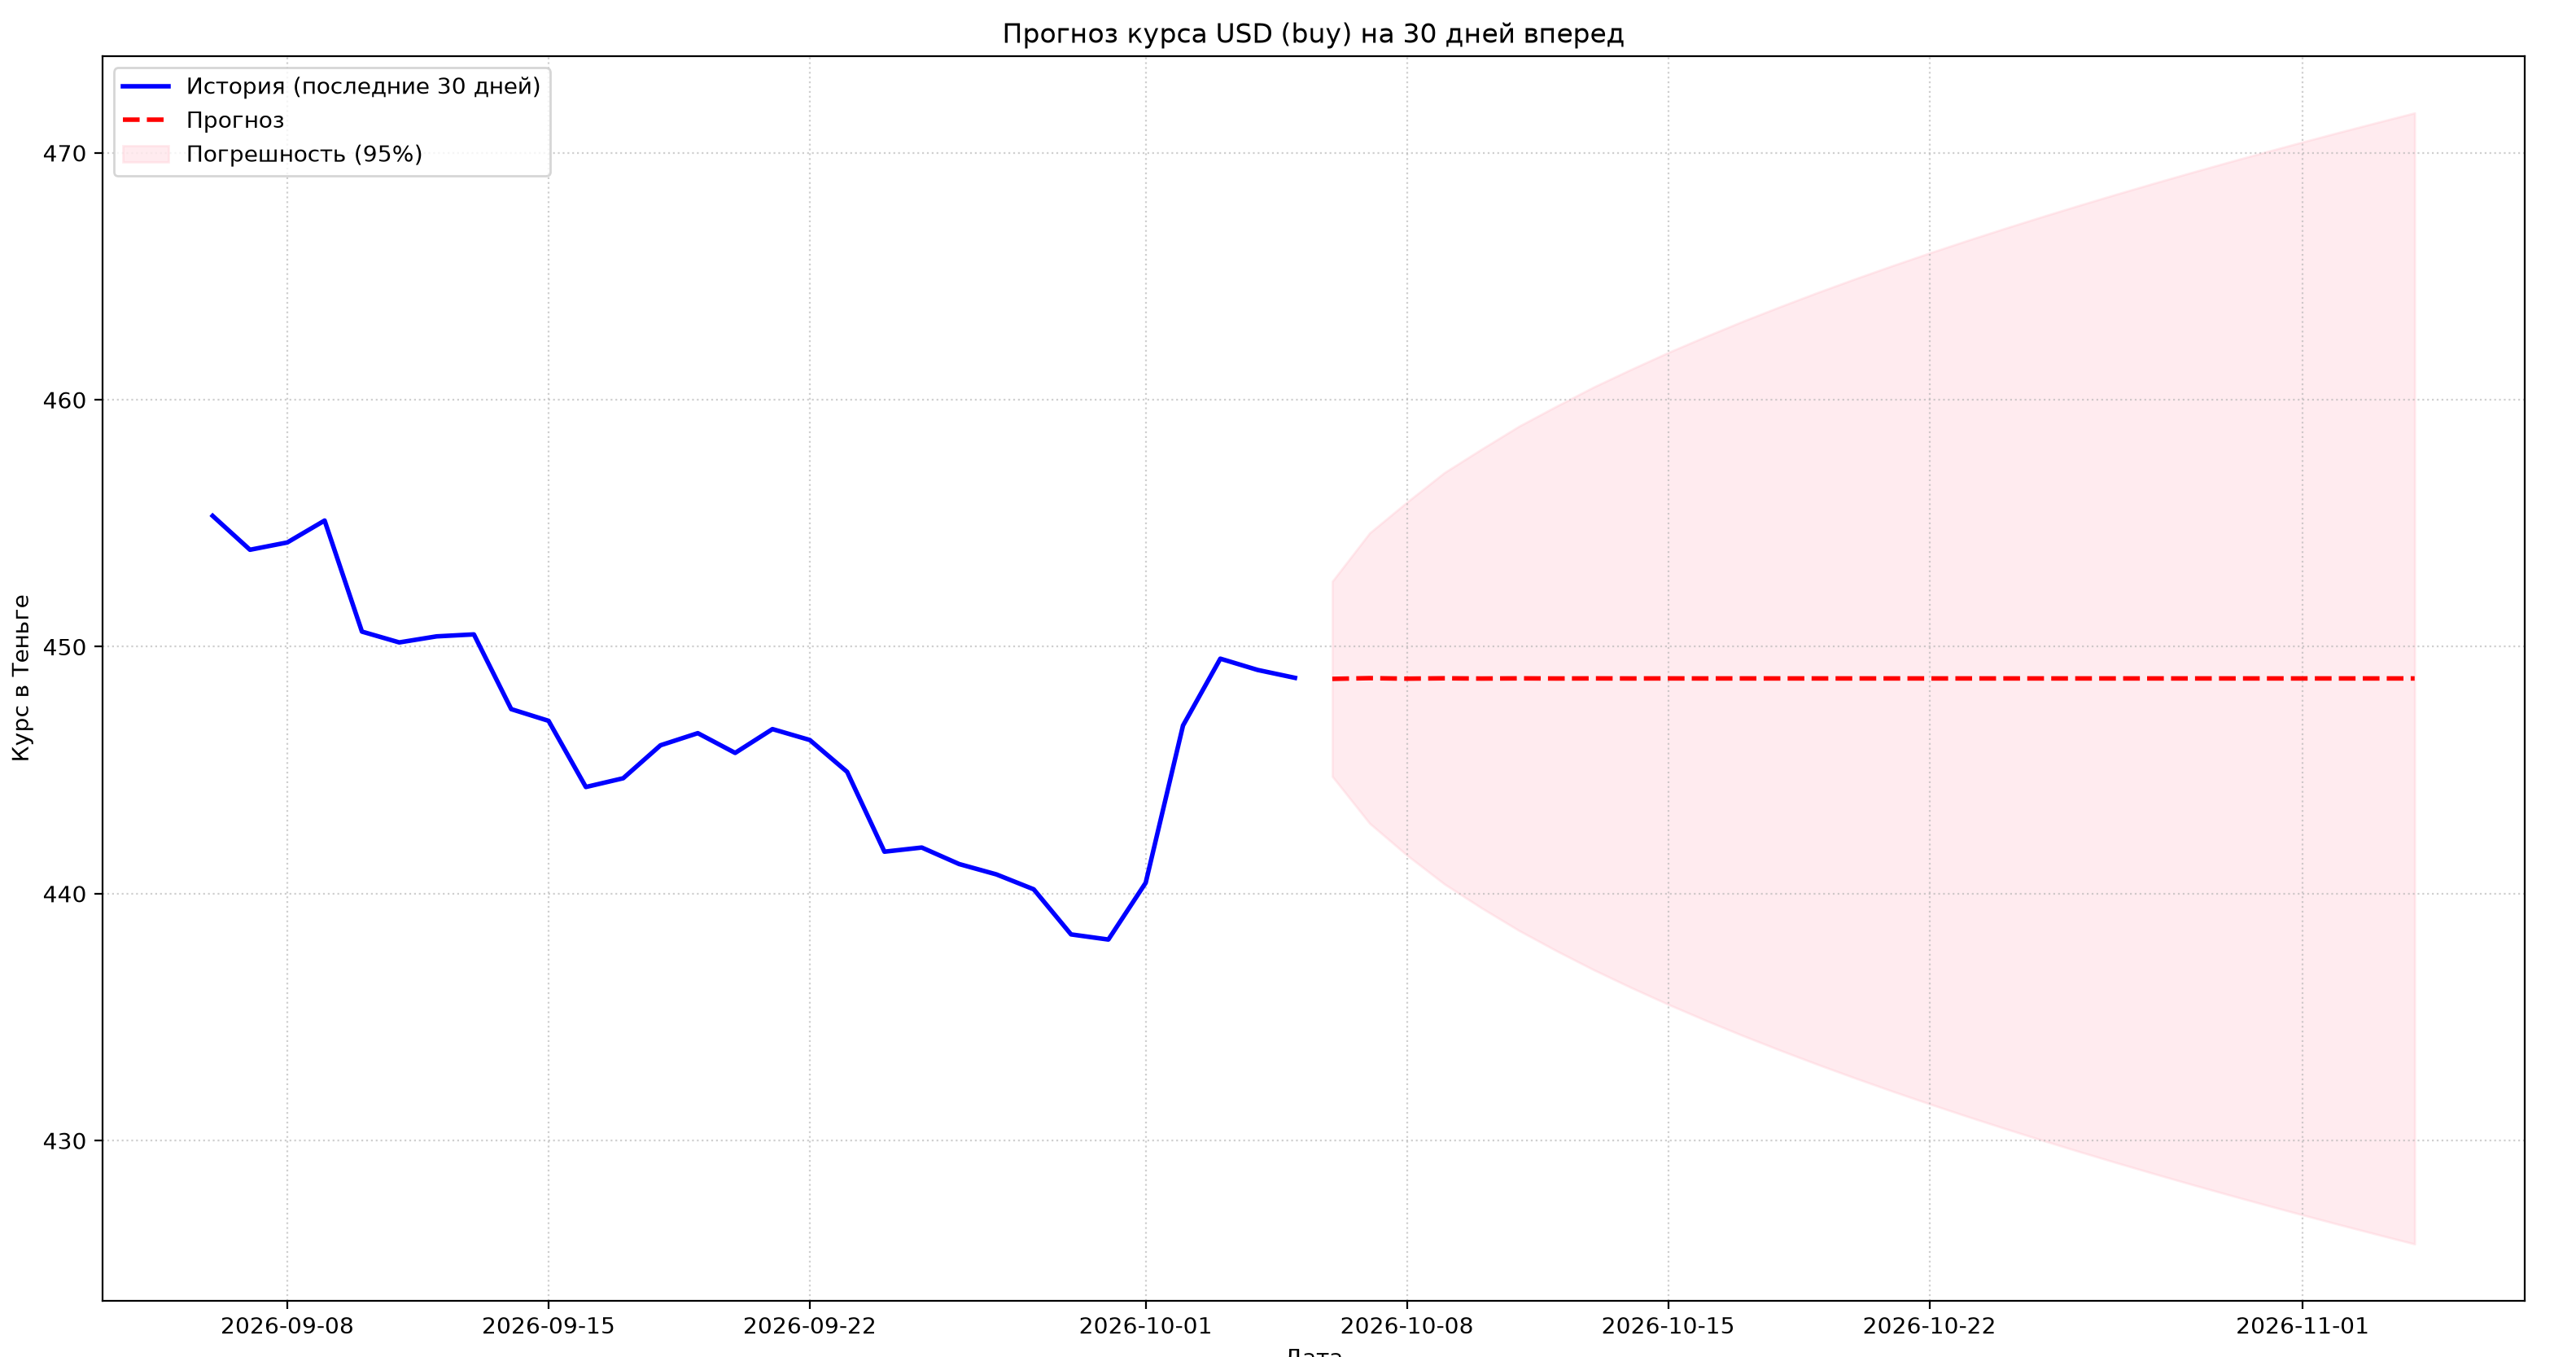
Точечное предсказание котировок вроде "Через 20 дней курс будет ровно 450" в реальной экономике несостоятельно. Модель SARIMAX рассчитывает математическое ожидание курса (наиболее вероятный тренд) и доверительные интервалы (Confidence Intervals) с уровнем статистической значимости α = 0.05 (95%-я уверенность).
Нижняя и верхняя границы доверительного интервала показывают зону риска. Чем дальше в будущее заглядывает прогноз, тем шире становится «веер» погрешности, наглядно демонстрируя аналитикам рост неопределенности.
def train_and_forecast(series: pd.Series, steps: int) -> tuple[pd.Series, pd.DataFrame]:
    logger.info("Запуск математического моделирования временного ряда...")

    # Инициализация и обучение модели
    model = SARIMAX(series, order=(1, 1, 1), enforce_stationarity=False, enforce_invertibility=False)
    model_fitted = model.fit(disp=False)

    # Генерация прогноза и расчет доверительного интервала 95%
    forecast_results = model_fitted.get_forecast(steps=steps)
    forecast_mean = forecast_results.predicted_mean
    confidence_intervals = forecast_results.conf_int(alpha=0.05)

return forecast_mean, confidence_intervalsДля финального отчета генерируется графическое представление с помощью matplotlib. Последние 30 дней реальной истории отображаются сплошной линией, прогноз — пунктиром, а зона неопределенности заливается полупрозрачным цветом. Это позволяет визуально оценить возможные экстремумы падения или роста валюты для формирования резервов компании.
# Логика построения графиков из save_and_plot_results()
plt.figure(figsize=(12, 6))
plt.plot(history_tail.index, history_tail.values, label="История", color="blue", lw=2)
plt.plot(forecast.index, forecast.values, label="Прогноз", color="red", linestyle="--", lw=2)

# Заливка зоны риска (доверительного интервала)
plt.fill_between(forecast.index, conf_int.iloc[:, 0], conf_int.iloc[:, 1],
                 color="pink", alpha=0.3, label="Погрешность (95%)")
plt.savefig(f"forecast_{currency.lower()}_chart.png", dpi=300, bbox_inches='tight')Для наглядности сопоставим задачи и ключевые инженерные решения, примененные в разработанных модулях:
Модуль | Ключевая технология | Основной вызов | Метод решения |
|---|---|---|---|
Парсер (Scraper) | Requests, BeautifulSoup | Нестандартная пагинация, русские названия дат | POST-эмуляция, Regex-маппинг словарей в Pandas |
База данных (Storage) | Pandas DataFrame, os.replace | Дубликаты при частых запусках, риск порчи файлов | Внутрипамятевое слияние (concat), атомарная запись через .tmp |
Мониторинг (Alerts) | urllib.request (Standard Lib) | Избыточность тяжелых библиотек, сетевые сбои | Прямые HTTP-запросы к Telegram API, обработка исключений try-except |
Прогнозирование (ML) | Statsmodels SARIMAX | Внутридневной шум, нестационарность котировок | Ресемплинг по дням (mean), дифференцирование ряда (d=1) |
Разработанный программный комплекс представляет собой законченное микросервисное решение. Оно полностью автономно, не требовательно к вычислительным ресурсам и может быть запущено на любом минимальном VPS-сервере.
Расширение параметров SARIMAX: Внедрение сезонных коэффициентов seasonal_order=(P, D, Q, s). Для валютных рынков актуальна недельная сезонность (s=7), отражающая закрытие бирж на выходные и падение ликвидности.
Переход на реляционную СУБД: При накоплении истории за несколько лет (сотни тысяч строк) плоский CSV-файл начнет замедлять операции слияния. На этом этапе модуль process_and_append_data можно бесшовно переписать на работу с SQLite или PostgreSQL с помощью метода df.to_sql().
Факторный анализ: Модель SARIMAX поддерживает подключение внешних экзогенных факторов (параметр exog). Добавление в модель исторических цен на нефть (для сырьевых валют) или ключевых ставок центробанков значительно повысит точность прогнозирования в моменты макроэкономических изменений.
Сcылка на готовый проект на Git
Ваш адрес электронной почты не будет опубликован. Обязательные поля помечены *